
Blog
Por qué se cayó Microsoft 365 el 12 de noviembre y cómo va la recuperación
Outlook, Teams, Copilot y otros servicios de Microsoft 365 fallaron durante horas el 12 de noviembre. Según Microsoft, no fue más tráfico: fueron servidores que dejaron de responder. Qué se sabe de la causa y cómo va la recuperación.
Si este jueves 12 de noviembre Outlook no abría, el problema no era el internet de la oficina. Desde la mañana, Microsoft 365 tuvo una falla que a las 10 de la noche seguía sin resolverse: el correo, el calendario, Copilot y otros servicios quedaron a medias durante horas, y Microsoft reconoció que podía afectar a usuarios de cualquier región. Su lista oficial de servicios afectados llegó a 19.
Leímos uno por uno los avisos que Microsoft publicó durante el día para contar qué pasó, qué dice la empresa sobre la causa y cómo va la recuperación. Todas las horas están en hora de Colombia, que en esta época del año es la misma de Nueva York.
Cómo empezó todo
- 9:45 a. m.: Teams empezó a fallar en Norteamérica. Ese incidente (TM1550488) se resolvió a las 10:53 a. m. y Microsoft lo atribuyó a una «contención de recursos», es decir, procesos compitiendo por la misma capacidad, según BleepingComputer. La empresa no ha dicho si tiene relación con lo que vino después.
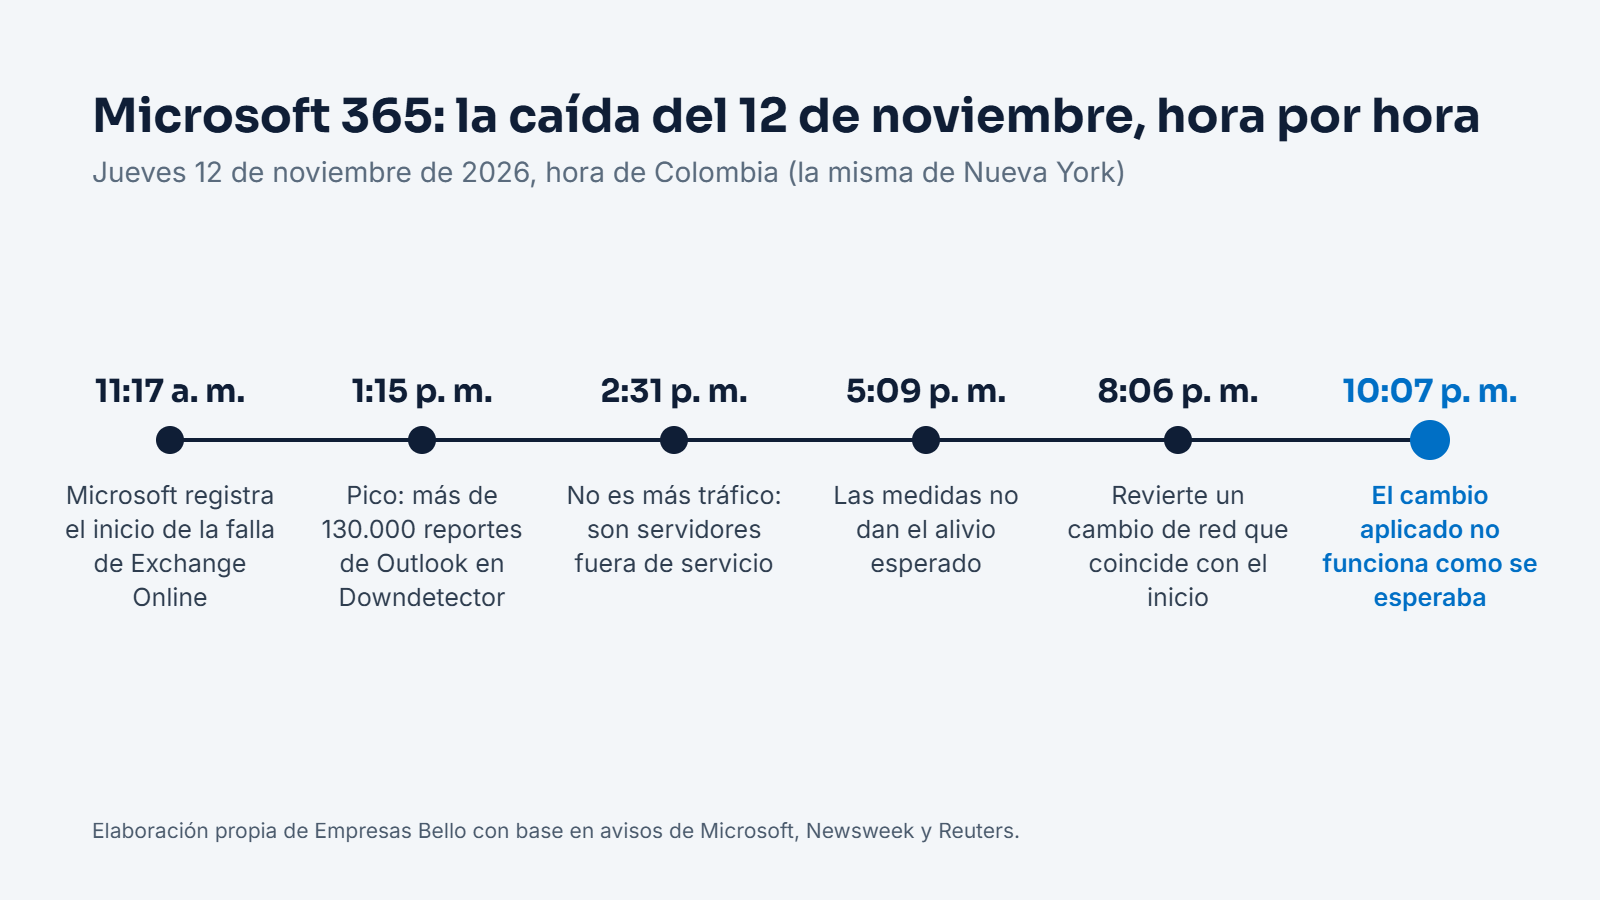
- 11:17 a. m.: es la hora de inicio que Microsoft registra para la falla de Exchange Online, el servicio que maneja el correo de Outlook (incidente EX1550543).
- 12:54 p. m.: Microsoft lo reconoció en X: usuarios con problemas para entrar a sus buzones en las Américas. Poco después aclaró que podía afectar a usuarios de cualquier región. Ese primer aviso pasaba de 12 millones de vistas en la noche.
- 1:15 p. m.: llegó el pico de quejas, con más de 130.000 reportes de Outlook y más de 48.000 de Microsoft 365 en Downdetector, según Newsweek. Antes de las 3 p. m. seguía habiendo unos 77.000 reportes de Outlook, según Al Jazeera y Reuters.
- 1:26 p. m.: Microsoft abrió un segundo incidente (MO1550821), porque la falla ya alcanzaba otros servicios.
La causa, según Microsoft, y cómo fue cambiando
Microsoft todavía no publica la causa raíz definitiva. Lo que sí hizo fue contar, aviso tras aviso, lo que iba encontrando. Leído en orden, se nota cómo cambió la explicación:
- Primero, carga elevada. A la 1:19 p. m. dijo que la infraestructura afectada tenía una carga elevada en varias regiones. A la 1:29 p. m. ya estaba desviando parte del tráfico de la infraestructura afectada en Estados Unidos.
- No era más tráfico. A las 2:31 p. m. explicó en X que esa carga no venía de un aumento del tráfico, sino de servidores que quedaron fuera de servicio de forma inesperada y recargaron al resto.
- Servidores que no pasaban el chequeo. Los servidores fallaban las revisiones automáticas de salud: las pruebas con las que el sistema decide si una máquina está bien para atender usuarios. Si no las pasa, la saca de servicio. A las 2:50 p. m. Microsoft dijo que probaba un cambio de configuración y reiniciaba todos los servidores afectados.
- Ningún cambio sospechoso, por ahora. A las 3:19 p. m. aseguró que no había encontrado ningún cambio reciente que coincidiera con el inicio y que el problema podía venir del componente que procesa la salud de los servidores.
- Un proceso central, desbordado. A las 5:09 p. m. admitió que sus acciones no habían dado el alivio esperado y que un proceso central de los servidores afectados se estaba desbordando, con pérdida de capacidad.
- El giro de la noche. A las 8:06 p. m. precisó que el proceso que se desborda es el que establece las conexiones seguras, y que había empezado a revertir un cambio reciente de configuración de red que coincide con el inicio del problema. Casi cinco horas después de decir que ningún cambio coincidía, apareció uno que sí.
Microsoft no ha hablado de ningún ataque. Todo lo que ha descrito son fallas de su propia infraestructura.
Cómo han intentado restablecerlo
El problema no ha sido solo encontrar la causa, sino volver a poner los servidores en pie. Esto es lo que Microsoft ha intentado, según sus propios avisos:
- Repartió el tráfico de Outlook por su infraestructura en todo el mundo y, a las 2:06 p. m., congeló todos los despliegues y cambios de configuración mientras revisaba los recientes.
- Reinició los servidores afectados, probó a saltarse el componente que procesa las revisiones de salud y, a las 3:56 p. m., validó otro método de revisión en una parte de la infraestructura.
- Aisló una parte de la infraestructura para probar la recuperación antes de aplicarla en todas partes.
- A las 6:04 p. m. dijo que ya devolvía una parte de los servidores al servicio y seguían estables, con una recuperación limitada.
- A las 6:59 p. m. vino el revés: los servidores recuperados pueden volver a quedarse sin responder en cuanto les llega tráfico. Por eso empezó a limitar qué tipos de tráfico llegan a la infraestructura afectada en algunas ubicaciones y a reconstruir parte de los servidores con una configuración de software anterior.
- A las 8:45 p. m. reportó resultados positivos al reiniciar la infraestructura afectada, y a las 9:09 p. m. dijo que estaba aplicando mejoras de capacidad para soportar el tráfico de las regiones que volvían a conectarse.
El último avance
A las 10:37 p. m., en su página pública de estado, Microsoft mantenía la falla como «degradación del servicio». Media hora antes había reconocido que el cambio que aplicó para mejorar el servicio «no está funcionando como se esperaba». En su último aviso dijo que, como parte de su investigación de los «desequilibrios sostenidos en la gestión del tráfico», revisa los flujos de tráfico y la infraestructura afectada para optimizar el enrutamiento, y que verifica las razones de las fallas para definir acciones concretas que mejoren la estabilidad. No ha dado una hora estimada de solución.
Para las cuentas personales, Microsoft decía a las 7:36 p. m. que seguía probando opciones de recuperación y que el problema afecta a Outlook.com, OneDrive, OneNote, To Do, Teams y Microsoft 365 para la web.
Este artículo recoge los avisos de Microsoft publicados hasta las 10:37 p. m. del 12 de noviembre, hora de Colombia. Microsoft anunció su siguiente actualización para antes de las 11:30 p. m.
Qué se cayó y qué siguió funcionando
Microsoft lo resumió así: fallan las funciones de Microsoft 365 que dependen de Exchange Online y del correo, y lo demás sigue funcionando. En la práctica, eso es mucho más que el correo:
- Outlook: en la web, en el computador y en el celular, con entregas de correo retrasadas.
- Teams: las llamadas, las reuniones, los chats de grupo y los mensajes en canales funcionan, pero falla todo lo que toca el calendario: agendar, invitar, ver o editar reuniones.
- Copilot: puede no cargar o quedarse sin acceso al correo, el calendario y los archivos de trabajo.
- Seguridad: Safe Links, la función de Microsoft Defender que revisa los enlaces cuando alguien hace clic, podría no verificar las URL en Outlook y Teams.
- Gestión y cumplimiento: Intune (inscripción y cumplimiento de equipos), Purview (prevención de pérdida de datos y contenido protegido), Planner, To Do, Universal Print y el propio centro de administración.
- Lo que sí funciona: los archivos guardados directamente en SharePoint.
Hay un detalle que lo dice todo: como el centro de administración también falló, Microsoft publicó la información en su página pública, porque «los administradores de Microsoft 365 podrían no poder acceder al centro de administración».
¿Y Gmail, AWS o X? Downdetector mostró reportes de muchos otros servicios, como recogió El Universal, pero ese artículo no trae confirmación de ninguna de esas empresas, y Microsoft no las menciona en sus avisos.
Lo que deja para una empresa
- El correo es más que correo. En esta caída se fueron con él el calendario, Copilot, la revisión de enlaces, la impresión y la gestión de equipos. Conviene tener claro qué procesos dependen de cada proveedor, con la misma lógica de gestionar el riesgo de terceros.
- Un plan B que no dependa del mismo proveedor. Un canal alterno para hablar con clientes y equipo, y saber dónde mirar: la página pública status.cloud.microsoft siguió informando cuando el centro de administración no cargaba. Prepararse en tiempos normales es la base de la resiliencia operativa.
- Leer la causa raíz cuando salga. Microsoft todavía no la publica. Cuando lo haga, se sabrá si el cambio de red fue el detonante. Mientras tanto, la lección sirve para cualquier empresa: los cambios de configuración se prueban antes, se aplican por partes y siempre con un camino para devolverse.
Fuentes
- Microsoft: Microsoft service health status, página pública de estado, consultada la noche del 12 de noviembre de 2026 (último aviso: 10:37 p. m., hora de Colombia).
- Microsoft 365 Status en X: avisos del 12 de noviembre de 2026 a las 12:54 p. m., 2:31 p. m., 2:50 p. m., 3:19 p. m., 5:09 p. m. y 6:04 p. m.
- Universidad de Pensilvania: Microsoft's Incident Report for PennO365, que reproduce los avisos de Microsoft de los incidentes EX1550543 y MO1550821.
- BleepingComputer: Massive Microsoft 365 outage disrupts Outlook, Teams, Copilot worldwide, 12 de noviembre de 2026.
- Newsweek: cobertura de la caída de Outlook, 12 de noviembre de 2026.
- Al Jazeera y Reuters: Microsoft outage hits tens of thousands of users, 12 de noviembre de 2026.
- SecurityWeek: Microsoft 365 Outage Disrupts Outlook, Exchange Online and Teams, 12 de noviembre de 2026.
- El Universal: Caída masiva impide iniciar sesión en Facebook, Outlook, Google y X, 12 de noviembre de 2026.
Fuentes consultadas el 12 de noviembre de 2026.